Lexikon Multimodale KI

Definition Multimodale KI

Multimodale KI sind Systeme, die mehrere Datenarten verarbeiten, etwa Text, Bilder, Audio, Video und Dokumente. Sie können diese Eingaben miteinander verbinden und je nach System auch mehrere Ausgabearten erzeugen.

Ein reines Textmodell liest und schreibt nur Text. Ein multimodales System kann zusätzlich ein Foto, eine Tabelle als Bild oder eine Sprachaufnahme verstehen und darauf antworten, zum Beispiel mit einer Beschreibung.
Inhaltsübersicht

Eine Modalität ist eine Datenart, etwa Text, Bild oder Ton. Multimodal heißt: mindestens zwei davon in einem System.

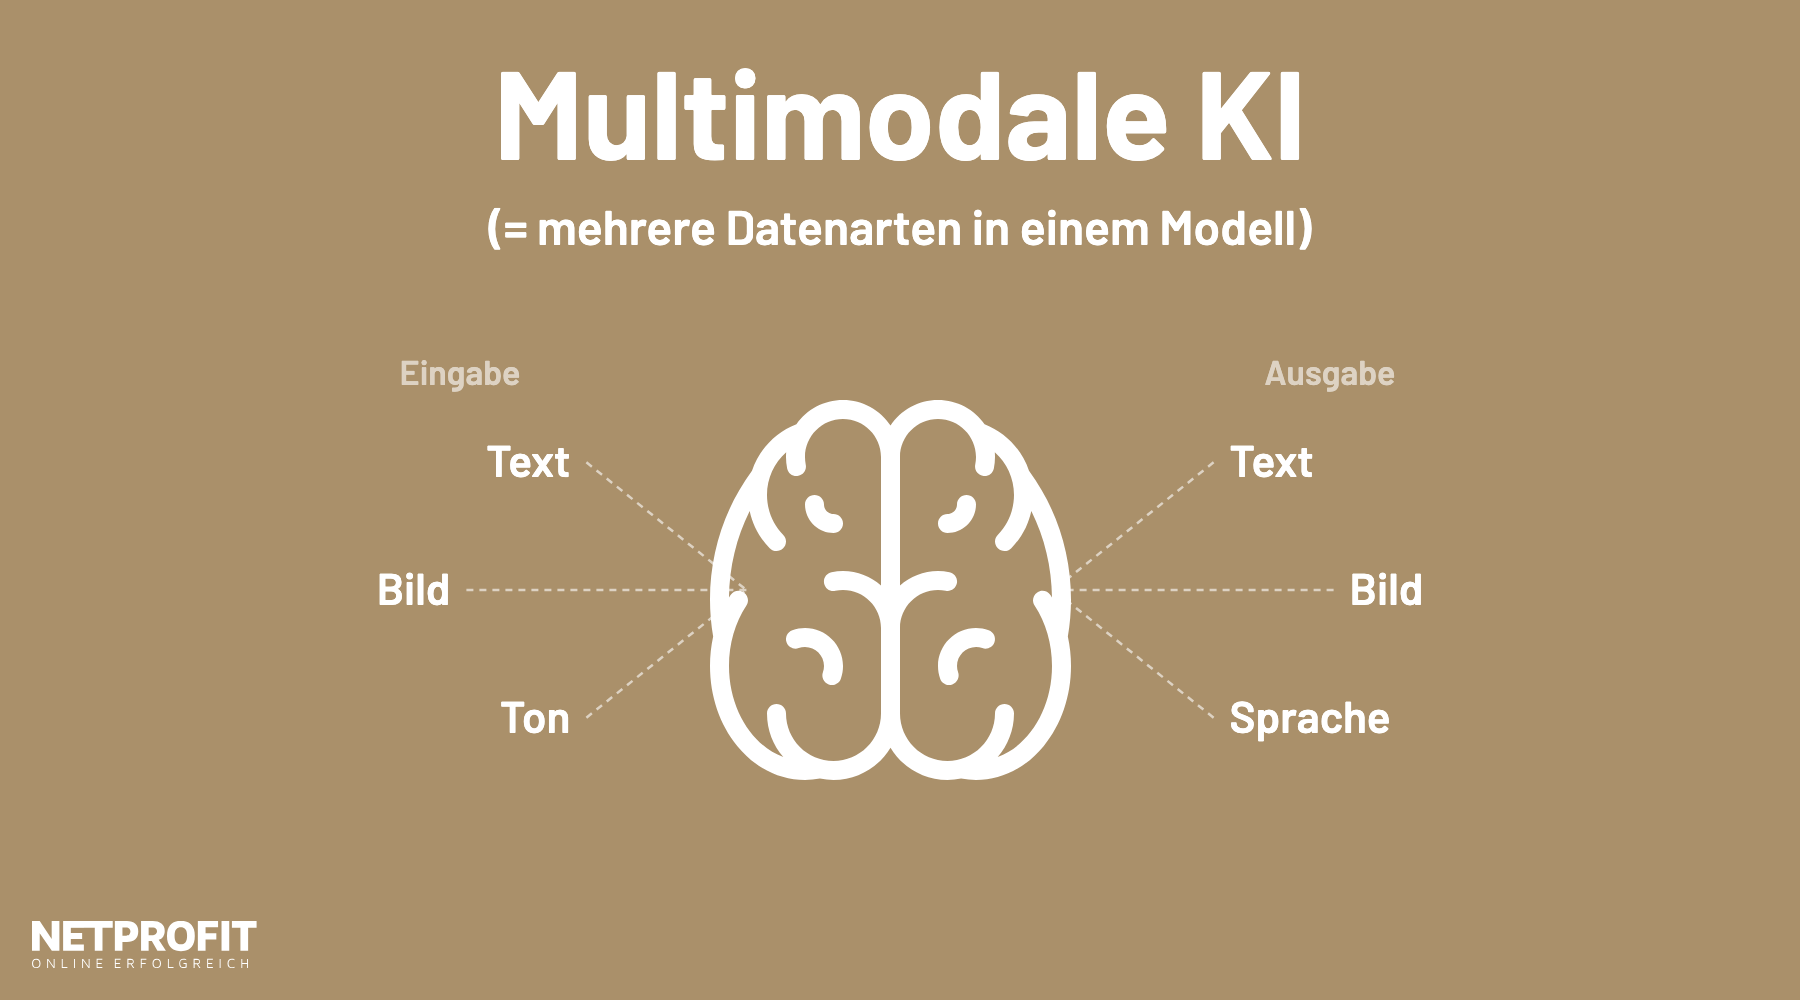
Ein KI-Modell in der Mitte, links Text, Bild und Ton als Eingaben, rechts Text, Bild und Sprache als Ausgaben
Multimodale KI verarbeitet mehrere Eingabearten in einem Modell und kann mehrere Ausgabearten liefern.

Bedeutung Warum ist multimodale KI wichtig?

Im Arbeitsalltag liegen Informationen selten nur als Text vor. Es gibt Screenshots, Präsentationen, gescannte Verträge, Fotos und Sprachnachrichten. Multimodale KI kann solche Inhalte auswerten, ohne dass jemand sie vorher mühsam abtippt.

Das BSI beobachtet, dass neben textbasierten Modellen zunehmend auch multimodale Modelle Beachtung finden, die mindestens zwei Formate verarbeiten.

Funktionsweise Wie funktioniert multimodale KI?

Technisch werden Text, Bild oder Ton in eine Form gebracht, die ein Modell gemeinsam auswerten kann. IBM beschreibt, dass multimodale Modelle Informationen aus mehreren Datentypen integrieren und dadurch mehr Kontext erfassen als Modelle für nur eine Datenart.

Google gibt für seine Gemini-Modelle an, sie seien von Beginn an multimodal angelegt. Anthropic beschreibt für Claude Text- und Bildeingabe mit Textausgabe. Die Systeme unterscheiden sich also darin, welche Eingaben und Ausgaben sie unterstützen.

Beispiel Typische Einsatzfelder

Multimodale KI taucht in vielen Anwendungen auf. Beispiele, die für Webseiten und Online-Marketing relevant sind:

  • Bildbeschreibung: Das System schlägt zu einem Foto einen Text vor, etwa als Entwurf für einen Alt-Text.
  • Dokumente und Screenshots: Tabellen, Diagramme oder Formulare lassen sich auswerten und zusammenfassen.
  • Sprachassistenten: Gesprochene Fragen werden verstanden und beantwortet.
  • Bildgenerierung: Aus einer Textbeschreibung entsteht ein Bild. DALL-E gehörte zu den frühen Beispielen.
  • Videoanalyse: Inhalte werden zusammengefasst oder beschrieben.

Praxis Multimodale KI im Online-Marketing

Ein Team lädt ein Foto von einem Produkt hoch und bittet die KI um einen Vorschlag für einen Bildtext. Der Entwurf spart Zeit, muss aber zur Seite passen. Wie ein Alt-Text sinnvoll aussieht, hängt von Bedeutung und Kontext des Bildes ab.

Auch bei Auswertungen von Screenshots oder Berichten hilft ein multimodales System bei der Vorarbeit. Die Verantwortung für Zahlen, Aussagen und Urheberrechte bleibt beim Menschen.

Abgrenzung Multimodale KI und reine Textmodelle

Ein LLM im engeren Sinn verarbeitet und erzeugt Text. Viele heutige Assistenten kombinieren ein Sprachmodell mit weiteren Fähigkeiten für Bild, Ton oder Dokumente und gelten dadurch als multimodal. Die Grenze ist fließend, weil Anbieter ihre Funktionen laufend erweitern. Stand 2026 gilt: Nicht jeder Assistent kann alles. Manche werten Bilder aus, erzeugen aber keine.

Grenzen Grenzen und Risiken

Die Dokumentationen der Anbieter und das BSI nennen typische Schwächen:

  • Fehler: Bei unscharfen, gedrehten oder sehr kleinen Bildern kann ein System Dinge falsch deuten oder erfinden (Halluzination).
  • Prüfpflicht: Google weist darauf hin, dass Ausgaben ungenau oder verzerrt sein können und menschliche Kontrolle nötig ist.
  • Täuschend echte Bilder: Erzeugte Bilder sind laut BSI häufig schwer von echten Aufnahmen zu unterscheiden.
  • Daten und Rechte: Trainingsdaten können laut BSI persönliche oder urheberrechtlich geschützte Inhalte enthalten, wodurch Datenschutz- und Urheberrechtsfragen entstehen können.

Das ist keine Rechtsberatung. Klären Sie Datenschutz und Urheberrecht, bevor Sie Fotos, Kundendaten oder fremde Bilder in ein KI-System geben.

FAQ Häufige Fragen zu multimodaler KI

Was bedeutet multimodal?

Multimodal bedeutet, dass ein System mehrere Datenarten wie Text, Bild, Audio oder Video verarbeitet.

Ist ChatGPT multimodal?

IBM nennt die erste Version als reines Textmodell und beschreibt, dass spätere Versionen multimodale Fähigkeiten erhielten. Der aktuelle Funktionsumfang hängt von Tarif und Stand ab.

Kann multimodale KI Bilder erzeugen?

Manche Systeme ja, andere nicht. Anthropic schreibt für Claude, dass es Bilder versteht, aber nicht erzeugt.

Kann multimodale KI Fehler machen?

Ja. Ausgaben zu Bildern, Dokumenten und Ton können falsch sein und sollten geprüft werden.

Fazit

Multimodale KI verbindet Text mit Bild, Ton und Dokumenten und erweitert so, was ein Assistent verstehen kann. Nutzen Sie sie für Vorarbeit und Entwürfe, prüfen Sie Ergebnisse und klären Sie Daten- und Rechtefragen vorab.

Quellen, weiterführende Links

Suche
insert coin
Katzen YouTube Thumbnail

Mit dem Aufruf des Videos erklären Sie sich einverstanden, dass Ihre Daten an YouTube übermittelt werden und Sie die Datenschutzerklärung akzeptieren.